











◇ 作者:中邮理财有限责任公司数字金融部IT经理 张赛
中邮理财有限责任公司研究部资深研究员 罗工书
中邮理财有限责任公司数字金融部资深IT经理 张明晖
◇ 本文原载《债券》2026年9月刊
摘 要
本文针对国债收益率预测中政策文本信息难以有效融合的问题,创新提出LLM-XGBoost混合预测架构,挖掘异质特征间的复杂交互关系,实现跨模态协同建模,输出未来第10个交易日10年期国债收益率的分类预测(“上行/震荡/下行”)。结果表明:政策特征显著提升预测性能,融合模型在测试集的分类准确率达74.27%,关键场景下的预测胜率突破88.89%,验证了模型对宏观环境突变的稳健性。本研究为利率预测提供了融合多源异构数据的新范式,其输出可直接驱动量化交易策略(如久期调整、收益率曲线套利),助力金融机构优化风险管理与资产配置决策。
关键词
LLM-XGBoost融合模型 国债收益率预测 政策文本分析 多模态特征学习
绪论
(一)研究背景
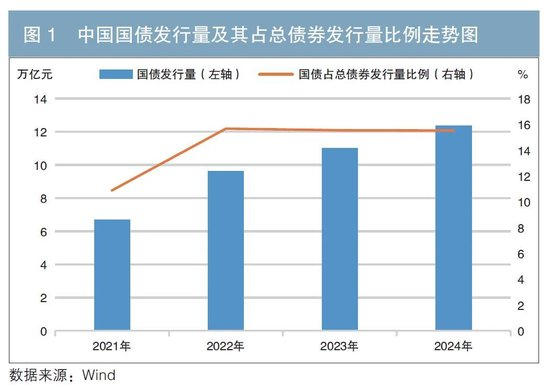
在我国经济高质量发展与金融市场深化改革的背景下,债券市场作为实体经济融资的重要支撑,呈现“规模扩张、结构优化、功能增强”的成熟化态势。其中,国债市场表现尤为突出,2024年发行量达12.4万亿元,占债券总发行量的比率保持稳定,凸显其在政府融资与流动性供给中的核心作用,成为反映利率水平和传递货币政策信号的关键载体(见图1)。
然而,当前金融领域的技术研究存在一些失衡:机器学习与深度学习多聚焦于股票、外汇等高波动市场,对规模庞大的债券市场研究相对匮乏,未能匹配其重要性。为填补此缺口,本文以10年期国债收益率为核心研究对象,系统整合政策文本、经济基本面及市场情绪等宏微观因素,创新引入XGBoost、LLM-XGBoost等差异化模型开展预测研究,旨在为债券市场定价分析与风险管理提供技术支撑。
(二)研究意义
银行理财公司投研体系以固收资产为核心、绝对收益为目标,10年期国债收益率作为无风险利率基准,是银行理财公司资产定价的锚点、大类资产配置的决策依据,以及利率风险管理的核心观测指标,直接影响产品收益表现与客户风险适配性。因此,在低利率常态化趋势下,深度研究10年期国债收益率走势已成为银行理财公司提升投研能力、优化客户服务的战略刚需。
研究现状
本文系统梳理了相关文献,主要从国债收益率的影响机制、预测模型应用两个核心维度构建研究框架。
(一)国债收益率的影响因素研究
国债收益率作为宏观经济与市场供需的“传导载体”,其影响因素研究重点呈现出从“结构化数据”向“非结构化信息”延伸的趋势。例如,在宏观经济方面,帅昭文等(2017)、曾鑫等(2019)证实了工业增加值增速(IPG)和居民消费价格指数(CPI)同比增长率的引入可显著提升国债收益率曲线拟合效果。在货币政策方面,穆贝雳(2023)研究发现,美联储政策对中国国债收益率短端的冲击以预期收益为主,对长端的冲击以风险溢价为主。
(二)国债收益率预测模型研究现状
国债收益率预测模型的发展经历了从传统方法到机器学习的演进。传统模型主要依赖结构化数据,涵盖时序模型、宏观经济结构化模型、收益率曲线模型三大类。例如,谢添(2023)研究发现SARIMA模型对10年期国债收益率的推演结果与宏观预测基本一致;邵兴宇等(2025)构建的基于DeepSeek的量化框架,揭示了政策强度与国债收益率的相关关系;杨婉茜和成力为(2015)证实了贝叶斯向量自回归模型预测中长期国债收益率的优越性。
然而,传统模型在捕捉非线性关系时存在明显局限。机器学习模型凭借对高维数据和非线性结构的适配优势逐步成为主流。例如,Nunes等人(2020)研究表明,带有额外内存的单变量长短期记忆模型能够取得与多变量多层感知器预测模型相似的预测结果。张继强等(2025)构建的BiGRU-Inception-Attention混合模型,通过注意力机制动态聚焦关键特征,显著提升10年期国债收益率周度方向预测胜率。
研究内容与创新点
本文针对国债收益率预测研究中非结构化数据利用不足的现状,系统构建了一个融合宏观基本面、市场情绪与政策文本信息的多维度预测框架,引入以下三个层面的创新点。
(1)多源信息融合机制创新:引入LLM技术提取政策文本的语义与情绪特征,构建“定量数据+政策文本定性信息”的双源特征体系,突破传统模型仅依赖结构化数据的局限。
(2)预测方法架构创新:提出LLM-XGBoost有机融合模型,充分发挥LLM在政策语义理解方面的优势与XGBoost在复杂非线性关系挖掘上的能力,实现多模态特征协同学习与端到端预测。
(3)研究视角与实用性创新:将预测目标明确为未来第10个交易日的三类趋势判断,既兼顾多频数据协调需求,也更贴合投资机构的中短期配置决策实际,显著提升模型的应用价值。
模型构建
(一)模型结构设计
本文提出LLM-XGBoost融合模型,创新性地构建“文本语义解析→多模态特征融合→集成学习协同预测”架构(见图2):利用DeepSeek提取政策文本的语义与情绪特征,拼接数值时序数据形成多模态输入矩阵,通过XGBoost学习异构特征间的复杂非线性关系,实现结构化与非结构化信息的协同学习,显著提升国债收益率预测精度。

(二)研究对象分析与定义
1.国债收益率走势分析
过去7年,我国10年期国债收益率呈现波动下行走势(见图3)。2018—2019年,受金融去杠杆与中美贸易摩擦影响,收益率自3.9%震荡下行。2020年,在新冠疫情冲击下,宽松货币政策引导利率创阶段新低,后随经济复苏小幅反弹。2021—2024年,经济下行压力增大,长期增长预期趋缓,叠加流动性充裕,推动收益率进入较大幅度下行通道。2024年末至2025年8月,利率在1.6%—2.5%的历史低位区间震荡,市场对政策正常化保持谨慎预期。

2.预测目标定义
为提升利率预判的实务可操作性,本文将预测目标定义为未来第10个交易日10年期国债收益率的三分类任务:收益率下行幅度超3BP(类别0)、收益率波动区间在上下3BP以内(类别1)、收益率上行幅度超3BP(类别2),分别对应经济意义上的“偏多”“震荡”“偏空”三种观点。本文旨在通过挖掘指标特征的变化来研判未来利率的变化趋势,突破传统回归模型对绝对值预测的过度依赖。
(三)数值型指标选取与数据处理
1.指标选取
基于对国内外文献的研究分析,本文选取2008年1月至2025年8月的数据作为建模样本,时间跨度共计4416天,所有原始数据均取自万得(Wind)金融终端,从宏观经济、货币政策与流动性、债市供求关系、情绪面和相对价值、高频基本面指标五个相互关联的大类构建了包含50多个指标的框架(见图4)。

2.数据处理
本文数据具有发布滞后、量纲不统一、更新不同频等特点,因此需要进行以下数据处理工作。
(1)滞后性处理:对滞后发布的指标数据,如国内生产总值(GDP)、CPI,在建模中将其发布时间与实际数据期对齐,避免使用未来信息。
(2)标准化处理:为最大化保留数据原始信息,本文采用前向滚动的Z-score标准化方法。考虑到不同数据(如季度、月度)的更新频率和波动特性不同,本文采用不同的滚动计算时长,以平衡其对市场变化的敏感性与稳定性。
(3)同频处理:对低频数据缺失值采用两步填补,先向前补缺以保证时序连贯;对仍缺失的点,统一填充为超出正常范围的常数(标准化后设为999.00)。该常数作为明确的缺失标志,便于模型识别。
(四)LLM模型构建
本文基于DeepSeek模型,采用提示词工程解析政策文本,构建“时间—政策”特征库。通过“感—标—锚”三步法实现力度分级:全景感知形成语义分布,分层定标划分5级强度,最终将新政策动态锚定至相应区间,完成定性量化(见图5)。

1. LLM模型提示词设计
本模型采用“角色与任务+核心原则+上下文处理+思维链(CoT)+输出规范+少样本示例(Few-Shot)”的提示词结构,将大模型设定为“一位精通中国金融市场政策演进与操作逻辑的资深分析师”,为每档设定明确的判断标准和关键词指引,评估政策的刺激或宽松力度,并按照固定格式生成分析结果,包括分档结论、理由、一个体现细微差异的倾向分值、对10年期国债收益率的影响分析及方向分类。
2.政策文本详细处理流程
(1)样本范围:政府官网公开文件(2008—2025年),覆盖财政政策、货币政策等内容,经去重清洗后保留496份有效文本。
(2)分级标准:依据政策力度与约束性划分为5级,使用DeepSeek-V3模型进行多阶段推理(见表1)。

①识别政策类型;
②提取关键词(如“降准降息”“超常规调节”);
③结合上下文语义标注强度(1—5级)及方向性(↑推升/↓压制收益率)。
(3)稳定性设计:采用多次独立评估,以平均得分作为政策强度估计值,显著降低模型随机性导致的评估方差。
3.政策指标构建
基于LLM标注结果生成四大类代理指标:
(1)政策哑变量:捕捉政策事件的离散冲击,定义如下:

(2)动态强度指标:用于衡量政策的历史变动,部分指标的计算逻辑列举见表2。

(3)交叉指标:引入强度—方向交叉项,检验政策异质性影响。

(4)政策滞后指标:考虑政策的滞后性,故增加滞后性指标,如财政类政策滞后3个月,货币类滞后1个月。

4.实证结果分析
通过分析政策分档与国债收益率未来第10天涨幅的关系,本文得出以下结论。
(1)低强度政策(等级1—2):更可能导致收益率上行,上行概率约为77.78%。这是由于低强度政策多为常规信号,未释放强烈宽松信号,难以显著压低利率。以2025年3月为例,央行未如期降准降息且进行中性操作(中期借贷便利等额续作)后,10年期国债收益率10日内上行18BP,至1.90%。
(2)高强度政策(等级3—5):更可能导致收益率下行,下行概率约为86.48%。这是由于等级3—5涵盖降准、降息、大规模再贷款等政策,明确释放稳增长决心,强化宽松预期,刺激利率下行。例如,2025年5月“双降”(降准0.5%及降息10BP)后,10年期收益率10日内从1.72%降至1.64%,下行约8BP(见图6)。

(五)LLM-XGBOOST模型构建
1.多模态特征矩阵构建
本研究采用异构数据协同编码架构,通过预训练语言模型(DeepSeek-V3)提取政策文本的语义嵌入向量

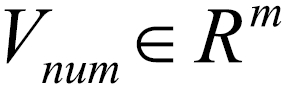


2.数据集划分
由于国债收益率是时间序列数据,为避免数据泄露,必须严格按照时序划分样本。本文采用滚动窗口法:设定5年数据为训练窗口,预测未来第10个交易日的收益率;完成后将窗口向后滑动一个时间步长,更新训练集和测试集,并重复此迭代过程,直至覆盖所有数据,确保模型始终基于历史信息进行预测(见图8)。

3.特征选择
本文基于XGBoost模型提供的特征重要性进行客观筛选,仅保留排名前50%的指标,有效剔除冗余特征。该方法在减少计算量的同时,显著提升了模型对利率变动的预测敏感性、解释力及样本外泛化能力,并降低了过拟合风险。
4.模型拟合
本文采用Python编程语言完成模型的构建与预测过程。针对国债收益率预测任务,所构建的XGBoost模型基于scikit-learn(sklearn)库中的XGBoost模块实现。参数的设置综合考虑了模型性能、过拟合风险与计算效率的平衡,为后续预测任务奠定了基础(见表3)。

模型结果分析
(一)损失函数分析
本模型选择交叉熵损失函数,其计算公式为:

其中,c为类别数,pi是真实标签的分布,qi是模型预测的概率分布。经过调优得到的最佳训练模型,损失函数逐步趋近于0(见图9)。

(二)不同市场环境下的表现分析
本文采用滚动窗口预测,模型在测试集上对10年期国债收益率未来第10日走势的预测值与真实值高度拟合。结合宏观背景的归因分析进一步验证了其有效性(见图10)。

(1)2024年5月至7月初,政策信号矛盾与资金面结构性分化使收益率呈现震荡格局,模型以84%的准确率捕捉到波动信号。
(2)2024年11月至次年1月,货币政策明确转向适度宽松并伴随降准降息,模型以88.89%的准确率识别利率下行趋势。
(3)2025年8月至9月初,供给端政策与股市资金分流共同推升利率,模型以85.71%的准确率判断出上行压力。
结果表明,本文构建的LLM-XGBoost融合模型不仅预测精度高,更能有效捕捉不同宏观环境下驱动利率变化的关键逻辑,具有良好的稳健性与实务应用价值。
(三)模型整体性能评估
LLM-XGBoost融合模型在国债收益率预测中表现出系统优势,准确率从72.57%提升至74.27%。精确率、召回率和F1分数均实现约1.6%的均衡提升,AUC值保持84.31%不变,表明模型在整体排序能力相当的同时,具体分类阈值下的判别性能更优。模型在不同类别上呈现异质性提升,反映了LLM文本特征注入的差异化影响(见表4)。

(1)“偏多”类别提升最为显著:F1分数由77.16%提升至78.79%(+1.63%),召回率提升2.00%,表明LLM对政策宽松等正面文本信号的捕捉有效增强了对上涨趋势的预测能力。
(2)“偏空”类别稳健改进:F1分数由76.13%提升至78.08%(+1.95%),主要受益于召回率的显著改善,显示模型对利空因素(如紧缩政策、通胀预期)的敏感度提高。
(3)“震荡”类别提升有限:F1分数仅从65.54%微升至66.89%(+1.35%),且AUC略有下降(78.09%→78.03%)。该类别的预测难度较大,LLM提供的宏观文本信息对界定市场均衡状态的辅助作用相对有限。
总之,LLM-XGBoost模型的性能提升验证了非结构化文本信息与结构化数值特征融合的有效性。但由于XGBoost本身是处理结构化数据、捕捉非线性关系的强大模型,LLM对政策文本的解析难以完全准确,且模型中缺乏社交媒体舆情、新闻流等高频情绪指标,因此LLM-XGBoost融合模型的边际提升空间有限。
模型在策略投资中的指导意义
该10年期国债收益率预测模型已趋成熟,其应用要点可总结如下:模型定位为辅助决策工具,旨在补充研究逻辑、辅助中短期资产配置,不适用于高频交易。使用者应重点关注其输出的概率分布,以判断观点力度,而非单一方向结论。模型状态的持续性转向信号通常预示基本面或情绪的关键变化,具有重要提示价值。为保持模型的时效性,建议每半年或遇重大宏观事件后重新训练,以吸收最新数据,维持性能稳健。
以2025年6月16日至30日的数据为例,本文使用训练好的模型预测10年期国债收益率在未来第10天的变化趋势,基于各状态的概率可以判断所有日期为“震荡偏多”,可辅助判断观点的“力度”和“偏向”,以降低观点的偏差,这在实战中也非常有意义(见表5)。

总结与展望
(一)研究总结
本文针对传统国债收益率预测模型难以有效融合非结构化政策文本与结构化时序数据的瓶颈,创新性地构建了LLM-XGBoost混合预测架构。结果表明,模型不仅能取得更高的数值预测精度,更能有效捕捉驱动利率走势的关键经济逻辑,为固收领域的智能投研提供了新的方法论支持。
尽管模型取得显著成果,但仍存在以下局限。
(1)文本噪声敏感:LLM对政策文本的解析依赖语义准确性,会议纪要中的模糊表述或修辞可能引入特征噪声,影响震荡区间预测的稳定性。
(2)高频数据融合缺失:未纳入市场实时情绪指标(如社交媒体舆情、新闻流),限制了对短期突发事件的响应速度。
(3)经济周期普适性待验:训练数据集中于2014—2025年中国市场,对极端经济场景(如流动性陷阱、通缩周期)的鲁棒性需进一步验证。
(二)未来研究方向
基于本研究的成果与局限,未来可从三个维度深化:数据层面,引入高频情绪指标与跨境资本流动数据,并探索政策文本的跨模态对齐,提升信号精度;模型层面,采用注意力机制优化特征选择,或引入图神经网络刻画政策逻辑依赖,增强推理能力;应用层面,将预测范围扩展至收益率曲线全域,开发自适应分类器提升震荡市判别力。此外,需在跨市场环境与极端经济周期中系统验证模型泛化性,推动预测范式发展。(本文为“第三届中债估值杯”征文活动获奖作品)












